¿Qué hace un ingeniero de datos?
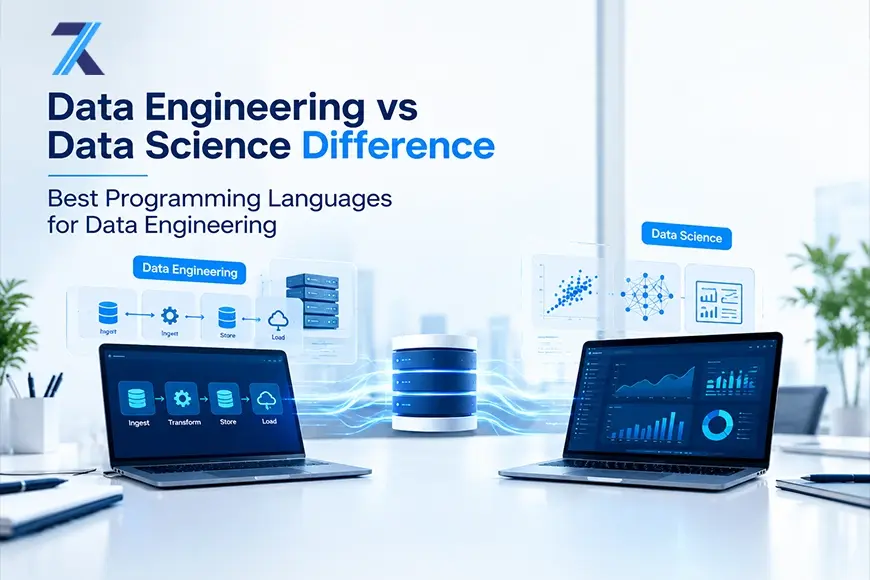
Un ingeniero de datos diseña la infraestructura técnica que permite a una organización utilizar sus datos de manera coherente y fiable. Los datos pueden provenir de aplicaciones, sitios web, pasarelas de pago, sensores, herramientas de atención al cliente o proveedores externos. Estas fuentes a menudo emplean formatos dispares y se actualizan en frecuencias distintas. El ingeniero de datos se encarga de crear los procesos que las integran en un sistema unificado.
Entre sus responsabilidades habituales figuran la construcción de canalizaciones de datos (data pipelines), la integración de fuentes, el diseño de bases de datos y almacenes de datos (data warehouses), la transformación de datos sin procesar en tablas estructuradas, la supervisión de procesos de datos, la optimización del rendimiento y la gestión del acceso y la seguridad. Su labor abarca tanto el procesamiento por lotes (batch processing), programado periódicamente, como la transmisión en tiempo real (streaming), donde la información se procesa al instante en que se genera.
La fiabilidad es una prioridad constante para los ingenieros de datos. No basta con que una canalización funcione una sola vez; debe mantener su estabilidad cuando el volumen de datos escala, una fuente modifica su esquema, se produce un fallo imprevisto o un nuevo equipo requiere acceso. Para garantizarlo, incorporan pruebas automatizadas, sistemas de alerta, documentación exhaustiva y protocolos de recuperación que aseguran la disponibilidad de los datos.
Sus entregables suelen incluir almacenes de datos en la nube, procesos automatizados de extracción y transformación, conjuntos de datos de clientes depurados, validaciones de calidad, flujos de eventos en tiempo real o arquitecturas de datos documentadas. La premisa esencial de su trabajo se resume en: ¿Pueden los datos correctos llegar al destino adecuado de forma confiable, segura y eficiente?
¿Qué hace un científico de datos?
Un científico de datos analiza la información para dar respuesta a preguntas estratégicas del negocio o de investigación. Su trabajo abarca desde comprender por qué los clientes abandonan un servicio y proyectar la demanda futura, hasta detectar transacciones sospechosas, desarrollar motores de recomendación, cuantificar el impacto de una campaña o anticipar qué incidentes requieren intervención prioritaria.
El proceso suele iniciarse con la formulación del problema y la exploración preliminar. El científico de datos revisa los datos disponibles, comprueba su integridad, analiza correlaciones y determina si la muestra es adecuada para abordar la interrogante planteada. Emplea estadística descriptiva para diagnosticar lo ocurrido, inferencia estadística para validar hipótesis y modelos de aprendizaje automático (machine learning) para predecir escenarios futuros.
Sus funciones abarcan la ingeniería de variables (feature engineering), el entrenamiento y validación de modelos, la comparación de metodologías, la ejecución de experimentos y la presentación de resultados. Asimismo, debe tener presentes los límites de su análisis: una correlación significativa no demuestra causalidad directa, y una predicción acertada sobre datos históricos puede perder precisión si los hábitos del consumidor evolucionan.
Entre sus principales entregables se encuentran informes analíticos, pronósticos, modelos de segmentación de usuarios, diseños de experimentos, algoritmos de recomendación, puntuaciones de riesgo y presentaciones ejecutivas orientadas a la toma de decisiones. Su objetivo central consiste en responder: ¿Qué nos revelan los datos, qué tendencias se perfilan y qué acciones debe adoptar la organización con base en ese conocimiento?
Principales diferencias entre ambos perfiles:
La divergencia más evidente se observa en la orientación de sus funciones. La ingeniería de datos se enfoca en la infraestructura y se sitúa en las fases iniciales (upstream) del ciclo de vida del dato. La ciencia de datos se orienta al análisis e interviene en las fases posteriores (downstream), utilizando la información ya estructurada para estudiar problemas concretos y extraer conclusiones de valor.
El ingeniero de datos prioriza la escalabilidad, la disponibilidad, la velocidad de procesamiento, la calidad de los datos y la seguridad. El científico de datos se concentra en la identificación de patrones, la cuantificación de la incertidumbre, la precisión predictiva, la experimentación y la interpretación del contexto. Mientras que el primero entrega sistemas y conjuntos de datos optimizados, el segundo produce análisis, modelos y recomendaciones estratégicas.
Los ciclos temporales de sus proyectos también difieren. La labor de ingeniería requiere continuidad, dado que las canalizaciones y plataformas precisan mantenimiento y supervisión constante. Los proyectos de ciencia de datos suelen ser exploratorios e iterativos, avanzando desde la formulación de una hipótesis hasta el diseño experimental y la validación del modelo. No obstante, una vez validado, el modelo exige desarrollo de ingeniería para integrarse de forma estable en producción, motivo por el cual los límites entre ambos roles tienden a difuminarse en equipos consolidados.
Sus criterios de evaluación también son distintos. El desempeño de un ingeniero de datos se mide por la estabilidad de las canalizaciones, los tiempos de procesamiento, la actualización de los datos, la contención de costes, el tiempo de operatividad (uptime) y los resultados de los tests de calidad. El éxito del científico de datos se cuantifica a través del rendimiento de sus modelos, el rigor experimental, la exactitud de sus proyecciones, el impacto en las métricas del negocio y la claridad estratégica de sus conclusiones.
Habilidades y herramientas de cada disciplina:
Ambos perfiles comparten la necesidad de dominar la programación, la resolución lógica de problemas, la comunicación interdisciplinaria y la gestión de estructuras de datos. SQL constituye una competencia transversal imprescindible: los ingenieros lo emplean para transformar y estructurar datos, mientras que los científicos lo utilizan para consultar y segmentar información. Python también es ampliamente adoptado en ambas áreas, aunque con aplicaciones distintas.
Los ingenieros de datos requieren una base sólida en ingeniería de software y arquitectura de sistemas. Su ecosistema habitual incluye motores SQL como PostgreSQL, bases de datos NoSQL, infraestructuras en la nube (AWS, Azure o Google Cloud) y marcos de procesamiento distribuido como Apache Spark. Para la gestión de flujos de datos en tiempo real emplean plataformas como Apache Kafka, mientras que la orquestación y calendarización de tareas se apoya en herramientas como Apache Airflow. También gestionan canalizaciones ETL/ELT, infraestructura como código, contenedores, control de versiones y normativas de gobernanza de datos.
Los científicos de datos demandan una preparación más profunda en matemáticas, estadística inferencial, diseño experimental y aprendizaje automático. Entre sus herramientas destacan entornos en Python o R junto a librerías como Pandas, NumPy, scikit-learn, TensorFlow y PyTorch, habitualmente en entornos interactivos como Jupyter Notebooks. Para la comunicación de hallazgos emplean librerías como Matplotlib o Seaborn, así como plataformas de inteligencia empresarial como Tableau o Power BI, apoyándose además en herramientas de seguimiento de experimentos y librerías especializadas en procesamiento de lenguaje natural o visión artificial.
Estas demarcaciones no son rígidas. Un ingeniero de datos puede implementar modelos predictivos ligeros para monitorizar el estado de un pipeline, mientras que un científico de datos puede escribir código para entornos productivos o diseñar transformaciones de datos complejas. La diferencia radica en la naturaleza del problema principal que cada uno resuelve, no en un listado estático de tecnologías.
Cómo colaboran en la práctica
Tomemos como ejemplo una cadena de distribución minorista que busca pronosticar la demanda de cada tienda. Los ingenieros de datos extraen el histórico de transacciones, los niveles de stock, las campañas de descuento, el calendario de festivos, la información meteorológica y las características de cada establecimiento. Homogeneizan las canalizaciones, corrigen discrepancias en los códigos de producto, depuran registros duplicados y dejan los datos preparados en el almacén analítico.
A continuación, el científico de datos explora el conjunto preparado para seleccionar las variables con mayor poder predictivo. Ensaya diversos algoritmos de previsión, compara precisiones, analiza los márgenes de error y calcula cómo las estimaciones pueden mejorar la reposición de inventario, exponiendo las ventajas y limitaciones al equipo de operaciones.
Si la empresa aprueba la implementación del modelo, la colaboración continúa. Los ingenieros configuran procesos automatizados para suministrar datos actualizados, almacenar las proyecciones, controlar fallos en la ejecución y servir los resultados a una interfaz o cuadro de mando. Al mismo tiempo, el científico de datos supervisa el comportamiento del modelo en producción para detectar caídas de precisión si los patrones de compra cambian.
Esta dinámica no es una entrega en un solo sentido. El científico de datos puede identificar que falta un dato esencial o que los registros horarios son inexactos, lo que lleva al ingeniero a ajustar la canalización para asegurar la frecuencia y precisión requeridas. Ambos se benefician de una documentación técnica compartida, definiciones claras y un alineamiento temprano sobre el objetivo de negocio.
El papel del Business Intelligence (BI)
La inteligencia de negocio (Business Intelligence o BI) se vincula con ambas áreas, aunque con un enfoque específico. BI transforma datos actuales e históricos en paneles ejecutivos, informes operativos y métricas de rendimiento accesibles. Permite contestar preguntas como: ¿Cuáles fueron las ventas del último mes? ¿Qué delegación no alcanza los objetivos? ¿Cómo evoluciona el volumen de incidencias de soporte?
La ciencia de datos suele adoptar una perspectiva más prospectiva: ¿Qué escenario es más probable a continuación? ¿Qué clientes tienen mayor propensión a darse de baja? ¿Qué estrategia de precios maximizará el margen operativo? Aunque se trata de una diferenciación esquemática —dado que BI puede incluir análisis avanzado y la ciencia de datos también evalúa datos históricos—, BI se orienta prioritariamente al diagnóstico descriptivo, mientras que la ciencia de datos aborda problemáticas predictivas y prescriptivas.
La ingeniería de datos actúa como el cimiento de ambas disciplinas, garantizando el flujo de datos fiables que nutre tanto a los cuadros de mando como a los modelos algorítmicos. En algunas organizaciones, los ingenieros analíticos (analytics engineers) se sitúan como nexo entre la ingeniería y BI, transformando la información del almacén de datos en modelos estandarizados y comprensibles para los analistas de negocio. En empresas emergentes estas funciones suelen solaparse, mientras que en organizaciones maduras se estructuran como áreas diferenciadas.
Formación y orientación profesional
No existe una titulación obligatoria para ninguno de los dos campos, aunque los perfiles académicos suelen alinearse con las exigencias del puesto. Los ingenieros de datos proceden frecuentemente de ingeniería informática, desarrollo de software, sistemas de información o disciplinas técnicas similares. Su formación prioriza el diseño de bases de datos, sistemas distribuidos, infraestructura cloud, algoritmia y arquitectura de software.
Los científicos de datos provienen habitualmente de estadística, matemáticas aplicadas, ciencias de la computación, economía cuantitativa, física o programas específicos de ciencia de datos. Su preparación académica hace hincapié en probabilidad, modelado econométrico, aprendizaje automático, metodología experimental y comunicación de resultados. En entornos orientados a la investigación los estudios de posgrado son frecuentes, si bien el desarrollo de proyectos prácticos y la experiencia técnica demostrable resultan determinantes.
Quien prefiera diseñar arquitecturas robustas, maximizar la estabilidad operativa, escribir código para entornos de producción y optimizar el rendimiento técnico tenderá hacia la ingeniería de datos. En cambio, quien disfrute explorando preguntas abiertas, aplicando razonamiento estadístico, experimentando con hipótesis y comunicando patrones complejos encontrará mayor afinidad con la ciencia de datos. Ninguna especialidad es superior en dificultad: la ingeniería exige rigor operativo frente a problemas de gran escala, mientras que la ciencia gestiona la ambigüedad y la incertidumbre. La elección depende del tipo de retos que a cada persona le motive resolver.
Malentendidos habituales
En primer lugar, la ingeniería de datos no equivale a la mera administración de bases de datos tradicionales. Si bien el dominio de bases de datos es básico, la ingeniería moderna engloba arquitecturas cloud, ingesta de eventos en streaming, orquestación de flujos de trabajo, observabilidad, seguridad perimetral y procesamiento distribuido a gran escala.
En segundo lugar, la ciencia de datos no se limita a entrenar algoritmos de machine learning. Un profesional cualificado dedica una parte sustancial de su tiempo a acotar el problema comercial, explorar la calidad de la muestra, plantear el diseño experimental, controlar posibles sesgos y sintetizar las conclusiones. Un modelo complejo no es intrínsecamente mejor que un análisis claro y accionable.
En tercer lugar, estas áreas no compiten entre sí. Una infraestructura de datos solvente no genera valor sin un análisis estratégico posterior, y un modelo sofisticado carece de validez si los datos de origen son deficientes. Los equipos más eficientes comprenden la interdependencia entre ambas funciones y coordinan a sus especialistas desde el inicio del proyecto.
Conclusión
La ingeniería de datos y la ciencia de datos atienden a distintas necesidades dentro del ciclo analítico. Los ingenieros de datos garantizan que la información sea fiable, accesible y esté lista para su explotación; los científicos de datos la analizan para explicar comportamientos, predecir tendencias y sustentar decisiones estratégicas. Aunque sus herramientas convergen y en estructuras reducidas un mismo profesional puede asumir ambas funciones, sus objetivos son diferentes: una disciplina construye la base y la otra extrae el valor analítico.
Para una empresa, la recomendación fundamental consiste en consolidar una infraestructura de datos rigurosa antes de esperar que los análisis avanzados produzcan resultados fiables. Colaborar con especialistas en Ingeniería de Datos asegura que los sistemas digitales se desarrollen sobre una base sólida desde el primer día. A nivel profesional, la elección entre una y otra depende del tipo de trabajo preferido: diseñar sistemas resilientes o investigar cuestiones abiertas. En cualquier caso, los mejores resultados se logran cuando ingeniería y ciencia colaboran de manera integrada, en lugar de actuar como departamentos aislados que se transfieren tareas incompletas.