データエンジニアの役割とは?
データエンジニアは、組織が一貫してデータを活用できるようにするための技術基盤を設計・構築します。データは、業務アプリケーション、Webサイト、決済システム、各種センサー、カスタマーサポートツール、あるいは外部プロバイダーなど多岐にわたるソースから生成されます。これらのデータソースはフォーマットが異なり、更新頻度もバラバラであることが一般的です。データエンジニアは、これらを統合し集約するための処理基盤を構築します。
主な責務には、データパイプラインの構築、各種ソースの統合、データベースやデータウェアハウスの設計、生データ(ローデータ)から利用可能なテーブルへの変換、データ処理ジョブの監視、システムパフォーマンスの向上、アクセス権限やセキュリティの管理などが含まれます。スケジュールに沿って一定間隔で処理を行うバッチ処理や、データ生成と同時にリアルタイムで処理するストリーミング処理など、要件に応じた処理方式を扱います。
データエンジニアは「信頼性」を何よりも重視します。一度だけ動くパイプラインでは不十分です。データ量が急増した際や、入力フォーマットが変更された場合、ジョブ障害が発生した際、あるいは他のチームが新たなアクセスを求めてきた場合でも、安定して稼働し続けなければなりません。エンジニアは、ダウンストリーム(後続工程)の利用者が安心してデータに依存できるよう、自動テスト、アラート通知、ドキュメント整備、障害復旧プロセスを組み込みます。
主な成果物としては、クラウドデータウェアハウス、自動化されたETL/ELTプロセス、整理・統合された顧客データセット、データ品質チェック機構、リアルタイムイベントパイプライン、文書化されたデータアーキテクチャ設計などが挙げられます。中心となる命題は常に、「適切なデータを、適切な場所に、信頼性が高くセキュアかつ効率的な形で届けることができているか?」という点にあります。
データサイエンティストの役割とは?
データサイエンティストは、データを駆使してビジネス上の課題や研究開発上の問いに対する答えを導き出します。顧客離脱の原因分析、将来の需要予測、不正取引の検知、レコメンデーションエンジンの構築、マーケティング施策の効果測定、優先対応すべき案件の特定などを手掛けます。
業務は通常、課題の定義とデータの探索から始まります。利用可能なデータを精査し、その品質を検証し、変数間の相関関係やパターンを探りながら、そのデータが投げかけられた問いに答え得るものかどうかを判断します。過去の状況を明らかにするための記述統計、仮説を検証するための統計的推測、将来の予測を行うための機械学習モデルなどを目的に応じて使い分けます。
データサイエンティストは、特徴量エンジニアリング、モデルの学習および精度評価、アルゴリズムの比較検討、A/Bテスト等の実験設計、そして分析結果のレポーティングを行います。また、自身の分析やモデルが持つ限界を正しく把握することも不可欠です。モデルが高い相関関係を示していても因果関係を証明しているとは限らず、過去データで高精度を誇る予測モデルであっても顧客の行動様式が変化すれば機能しなくなるリスクを常に考慮します。
成果物には、分析レポート、需要予測、顧客セグメンテーションモデル、実験検証計画、レコメンドアルゴリズム、リスクスコア算出ロジック、経営層向けプレゼンテーションなどが含まれます。中心となる命題は通常、「データは何を物語っているのか、次に何が起こり得るのか、そして組織はその洞察をもとにどのようなアクションを起こすべきか?」という点です。
主な違い:
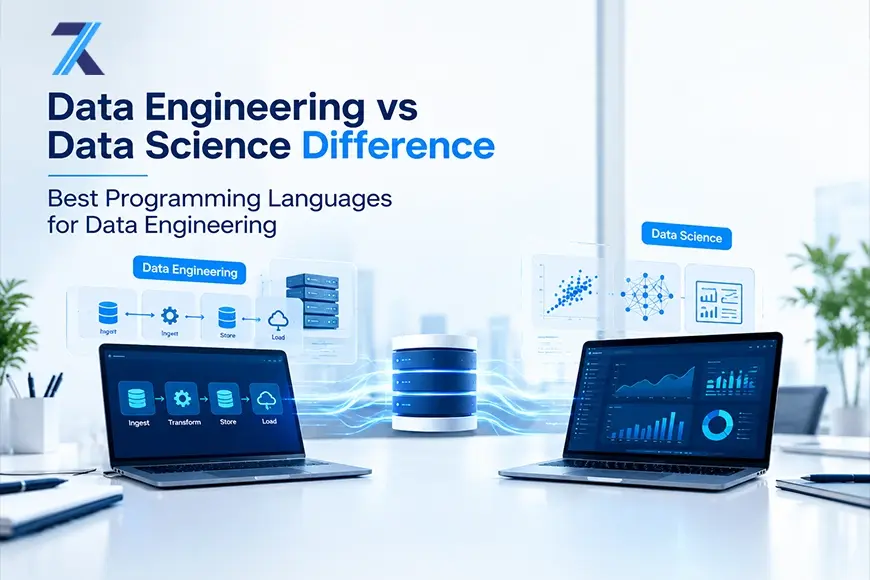
最も明確な違いは、業務が向いているベクトルにあります。データエンジニアリングは一般にインフラ・基盤志向であり、データライフサイクルの「上流」で機能します。一方、データサイエンスは分析・探索志向であり、データライフサイクルの「下流」において、準備されたデータを活用して課題を検証しインサイトを抽出します。
データエンジニアが関心を寄せるのは、スケーラビリティ、可用性、処理パフォーマンス、データ品質、そしてセキュリティです。データサイエンティストが関心を寄せるのは、隠れたパターン、不確実性、モデル精度、予測力、実験設計、そしてビジネス的解釈です。エンジニアは「システム」と「データセット」を生み出し、サイエンティストは「分析結果」「予測モデル」「推奨アクション」を生み出します。
プロジェクトの時間軸にも違いが見られます。パイプラインやプラットフォームは継続的な運用・保守を伴うため、エンジニアリング業務は定常的・継続的な性質を持ちます。対してデータサイエンスの案件は探索的かつ反復型であり、「問い」から「実験」、そして「モデル化や提言」へと段階的に進みます。ただし、実用化されたモデルを本番環境で安定稼働させるにはエンジニアリングの手腕が不可欠であり、成熟したチームになるほどこの境界はシームレスに交差します。
評価基準(KPI)も異なります。データエンジニアは、パイプラインの稼働率・信頼性、処理時間、データの鮮度、クラウドコスト、データ品質テストの結果などで評価されます。データサイエンティストは、モデルの精度、実験設計の妥当性、予測的中率、ビジネスへの売上・効率貢献度、施策への採択率、提言の明快さなどで評価されます。
各役割で求められるスキルとツール:
プログラミング能力、課題解決力、コミュニケーション能力、データ構造の基礎理解は両者に共通して求められます。SQLは特に共通しており、エンジニアはデータの管理や加工・変換に、サイエンティストはデータの抽出や集計・検証に用います。Pythonも双方で標準的に採用されていますが、その利用用途やライブラリ群は異なります。
データエンジニアには、強固なソフトウェアエンジニアリング力とシステム構築のスキルが求められます。ツールセットとしては、PostgreSQLなどのリレーショナルデータベース、NoSQLシステム、AWS・Azure・Google Cloudといったパブリッククラウド、Apache Sparkなどの分散処理フレームワークが代表的です。イベントストリーミングにはApache Kafka、ワークフローのスケジューリングと監視にはApache Airflowなどが多用されます。さらに、ETL/ELTツール、IaC(Infrastructure as Code)、コンテナ技術、Gitによるバージョン管理、データガバナンスツールの運用スキルも重要です。
データサイエンティストには、統計学、応用数学、実験設計、機械学習アルゴリズムに関する深い知見が要求されます。代表的なツールや言語には、Python、R、Pandas、NumPy、scikit-learn、TensorFlow、PyTorch、Jupyter Notebookなどがあります。分析結果を分かりやすく可視化するために、Matplotlib、Seaborn、Tableau、Power BIなども幅広く活用されます。また、SQL、クラウド上のノートブック環境、MLOps系のモデル管理ツール、自然言語処理や画像認識に特化したライブラリを扱う機会も豊富です。
これらは厳格に線引きされるものではありません。データエンジニアがパイプラインの監視のために簡易的な予測モデルを組み込むこともあれば、データサイエンティストが本番向けコードを記述したりデータ変換ロジックを設計したりすることもあります。両者の本質的な違いは、使用するソフトウェア名ではなく「各人が最終的に解決すべき中核課題」によって定義されます。
両者が連携して成果を出すプロセス
店舗ごとの需要予測を行いたい小売企業を例に考えてみましょう。データエンジニアは、購買トランザクション履歴、店舗在庫数、セール情報、祝日カレンダー、気象データ、店舗属性などの情報を各所から収集します。一貫性のあるデータパイプラインを構築し、異なる商品コード体系の統一、重複データの排除を行い、クレンジングされたデータをデータウェアハウスや機械学習環境へスムーズに供給できるように整えます。
次に、データサイエンティストがそのデータを精査し、予測に寄与する特徴量を特定します。複数の予測アルゴリズムを検証・比較し、誤差分析を行い、その予測モデルが在庫発注やロス削減にどれほど寄与するかを試算します。そして、精度と計算コストのトレードオフなどを事業部門やプロダクトチームへ分かりやすく解説します。
組織がそのモデルの本格導入を決定すると、両者の連携はさらに深化します。エンジニアは、最新データを定期的にモデルへ流し込み、推論結果を保存し、エラーを監視した上で基幹システムやダッシュボードに予測値を連携する本番配信基盤を実装します。データサイエンティストはモデルの精度低下を監視し、市場や顧客トレンドの変化によって再学習が必要かどうかをチェックします。
これは一度きりのバトンタッチではありません。「分析に不可欠なデータ項目が抜けている」「タイムスタンプの精度にブレがある」といったサイエンティストのフィードバックを受け、エンジニアがパイプラインを改修し、必要な更新頻度でデータを提供できるように調整します。双方が用語や仕様を統一し、共有ドキュメントを整え、目指すべきビジネスゴールを初期段階で合意しておくことがプロジェクト成功の鍵となります。
ビジネスインテリジェンス(BI)との位置づけと関係性
ビジネスインテリジェンス(BI)は双方の領域と密接に関係していますが、その主眼は異なります。BIは主に現在および過去のデータを集計・可視化し、直感的なダッシュボードや定期レポート、KPIモニタリング画面を提供します。「先月の売上はどうだったか?」「目標未達の地域はどこか?」「サポート問い合わせの傾向はどう変化しているか?」といった問いに迅速に答える役割を果たします。
これに対してデータサイエンスは、より将来の動向に焦点を当てます。「次に何が起こる可能性が高いか?」「解約リスクを抱えている顧客は誰か?」「どの価格設定や施策が最も成果を最大化できるか?」といった問いを探求します。もちろんBIでも高度な相関分析を行うことがあり、データサイエンスでも過去実績の要約を行うため、境界が曖昧な部分もありますが、一般にBIは「記述的・現状把握的」、データサイエンスは「予測的・処方的」な役割を担います。
データエンジニアリングは、このBIとデータサイエンスの双方を下支えする土台です。ダッシュボードや機械学習モデルが参照する、整合性の取れたクリーンなデータを常に供給し続けます。組織によっては、エンジニアリングとBIの間に「アナリティクスエンジニア」を配置し、ウェアハウス内のデータをアナリストやビジネスユーザーが即座に活用できるデータマートへとモデリングする役割を設ける場合もあります。スタートアップ等では1人が複数の役割を兼任することも多い一方、大規模組織になるほど専門領域として明確に分業化されます。
学歴とキャリアの方向性
どちらの職種においても特定の学位が絶対条件となるわけではありませんが、一般的な出身専攻には各業務の特性が色濃く反映されます。データエンジニアは、コンピュータサイエンス、ソフトウェアエンジニアリング、情報システム工学などの出身者が多く見られます。その履修過程では、データベース設計、分散システム、クラウドインフラ、プログラミング、システムアーキテクチャが重点的に扱われます。
データサイエンティストは、統計学、応用数学、情報科学、経済学、物理学、あるいは専門のデータサイエンス学科などを専攻してきた人材が中心です。確率論、統計モデリング、機械学習アルゴリズム、実験計画法、データプレゼンテーションに強みを持ちます。研究開発寄りの高度なポジションでは大学院(修士・博士)での研究実績が評価されることもありますが、実務プロジェクトの完遂実績や確かな技術的エビデンスも同様に重視されます。
堅牢なシステム設計、障害耐性や信頼性の向上、プロダクション品質のコード設計、大規模処理の最適化にやりがいを感じる人には、データエンジニアリングが適しています。答えが定まっていない問いの探求、統計的思考、仮説検証、パターン発見、そしてビジネスへの提言に情熱を注げる人には、データサイエンスが適しています。どちらが一方的に難易度が高いということはありません。エンジニアリングには高負荷環境下での運用力や拡張性が求められ、サイエンスには不確実性や曖昧さに向き合う思考力が求められます。自身の強みと解決したい課題の性質に応じて選択するのが理想的です。
よくある誤解
第一に、データエンジニアリングは単なるデータベース管理(DBA)ではありません。データベースの知識は重要ですが、現代のデータエンジニアリングは、クラウド基盤設計、ストリーミング処理、オーケストレーション、自動テスト、オブザーバビリティ(可観測性)、セキュリティ、分散大規模処理など、はるかに広範な領域を包括しています。
第二に、データサイエンスは機械学習アルゴリズムを回すことだけではありません。優れたデータサイエンティストは、課題の再定義、探索的データ分析、実験設計、バイアスの検証、ステークホルダーへの丁寧な説明に多くの時間を投資します。複雑怪奇なモデルを構築することよりも、本質を突いたシンプルな分析の方がビジネス価値を高く発揮することは多々あります。
第三に、この2つの職種は競合関係ではありません。いくら堅牢なデータプラットフォームがあっても高度な分析がなければ価値は引き出せず、どれほど精密なモデルがあっても元となるデータ基盤が粗悪であれば機能しません。成果を出すデータ組織とは、両者の役割分担と連携プロセスを深く理解し、適切な専門家を初期からプロジェクトに参画させている組織です。
まとめ
データエンジニアリングとデータサイエンスは、ひとつのデータライフサイクルの中で異なる問いに答える補完関係にあります。データエンジニアはデータを信頼性が高く、アクセスしやすく、活用可能な状態へと整え、データサイエンティストはそのデータを活用して事象を解明し、未来を予測し、より的確な意思決定を後押しします。 使用ツールが一部共通し、小規模組織では兼任されることもありますが、その核となるミッションは明確に異なります。すなわち、一方が強固な基盤を構築し、もう一方がそこから本質的な意味と価値を紡ぎ出すのです。
企業における実務的な教訓としては、高度なデータ分析に成果を求める前に、まずデータの基盤課題をしっかりと解決しておくことが鉄則です。データエンジニアリングの専門家と提携することで、初期段階から盤石なデータアーキテクチャの上にシステムを構築することが可能になります。 個人にとっては、自身の適性が「堅牢で拡張性の高いシステムを構築すること」と「不確実な問いをデータで解き明かすこと」のどちらに向いているかという選択になります。いずれの立場であっても、分断された作業の受け渡しではなく、エンジニアリングとサイエンスが対等なパートナーとして緊密に連携したときにこそ、最大のビジネスインパクトが創出されます。