Che cosa fa un data engineer?
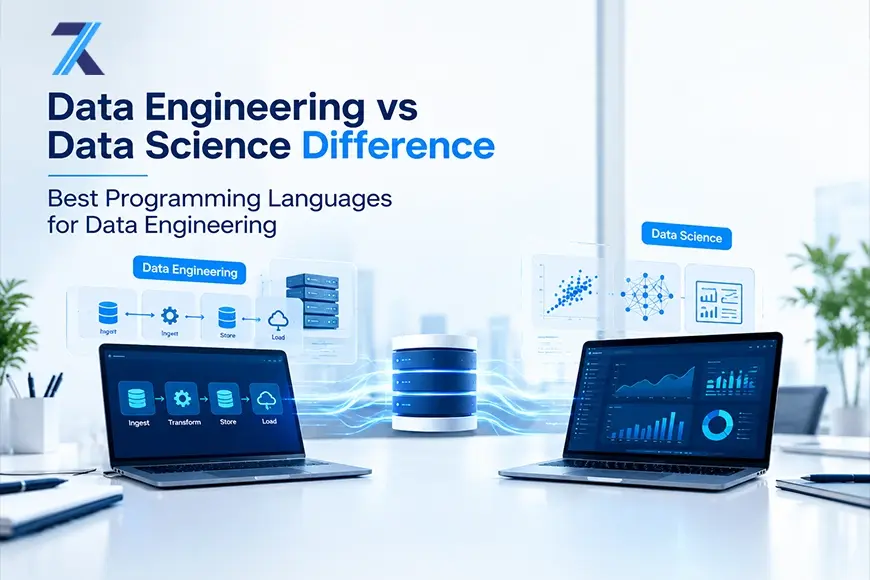
Un data engineer progetta le fondamenta tecniche che consentono a un'organizzazione di utilizzare i dati in modo coerente. I dati possono provenire da applicazioni, siti web, sistemi di pagamento, sensori, strumenti di assistenza clienti o provider esterni. Spesso queste fonti utilizzano formati diversi e si aggiornano in momenti differenti. Un data engineer realizza i processi che li uniscono.
Tra le responsabilità tipiche vi sono la creazione di pipeline di dati, l'integrazione delle fonti, la progettazione di database e data warehouse, la trasformazione dei dati grezzi in tabelle utilizzabili, il monitoraggio dei job di dati, il miglioramento delle prestazioni del sistema e la gestione degli accessi e della sicurezza. Il lavoro può comportare l'elaborazione in batch, in cui i dati vengono spostati secondo una pianificazione, o lo streaming, in cui le informazioni vengono elaborate man mano che vengono generate.
I data engineer si occupano anche di affidabilità. Una pipeline che funziona una sola volta non basta. Deve continuare a funzionare quando il volume dei dati cresce, una fonte cambia formato, un job fallisce o un altro team ha bisogno di accedere. Gli ingegneri aggiungono test, avvisi, documentazione e processi di ripristino in modo che gli utenti a valle possano dipendere dai dati.
I loro deliverable potrebbero includere un data warehouse cloud, un processo automatizzato di estrazione e trasformazione, un set di dati dei clienti pulito, controlli sulla qualità dei dati, una pipeline di eventi in tempo reale o un'architettura dei dati documentata. La domanda centrale di solito è: I dati giusti possono raggiungere il posto giusto in una forma affidabile, sicura ed efficiente?
Che cosa fa un data scientist?
Un data scientist lavora con i dati per rispondere a domande di business o di ricerca. Può indagare sul motivo per cui i clienti se ne vanno, stimare la domanda futura, identificare transazioni insolite, consigliare prodotti, misurare l'effetto di una campagna o prevedere quali casi richiedono attenzione.
Il lavoro di solito inizia con la definizione del problema e l'esplorazione. Un data scientist esamina i dati disponibili, ne verifica la qualità, cerca relazioni e decide se possono supportare la domanda posta. Può utilizzare la statistica descrittiva per spiegare cosa è successo, l'inferenza statistica per testare un'idea o il machine learning per prevedere i probabili risultati.
I data scientist creano feature, addestrano e valutano modelli, confrontano approcci, eseguono esperimenti e comunicano i risultati. Devono inoltre comprendere i limiti del proprio lavoro. Un modello può mostrare una forte relazione senza dimostrare che un fattore ne ha causato un altro. Una previsione può essere accurata sui dati storici ma fallire quando il comportamento dei clienti cambia.
I loro deliverable possono includere un report di analisi, una previsione, un metodo di segmentazione della clientela, la progettazione di un esperimento, un modello di raccomandazione, uno score di rischio o una presentazione per i decisori. La domanda centrale di solito è: Cosa ci dicono i dati, cosa potrebbe accadere dopo e cosa dovrebbe fare l'organizzazione con questa conoscenza?
Le differenze principali:
La differenza più evidente è la direzione del lavoro. La data engineering è generalmente orientata all'infrastruttura e opera a monte nel ciclo di vita dei dati. La data science è generalmente orientata all'analisi e opera a valle, utilizzando dati preparati per indagare sui problemi e produrre insight.
Un data engineer si preoccupa di scalabilità, disponibilità, prestazioni, qualità dei dati e sicurezza. Un data scientist si preoccupa di pattern, incertezza, qualità del modello, previsione, sperimentazione e interpretazione. L'ingegnere produce spesso sistemi e set di dati. Lo scienziato produce spesso analisi, modelli e raccomandazioni.
Anche i loro orizzonti temporali possono differire. Il lavoro di ingegneria è spesso continuo perché pipeline e piattaforme richiedono manutenzione. I progetti di data science possono essere esplorativi e iterativi, passando da una domanda a un esperimento e poi a un modello o a una raccomandazione. Tuttavia, un modello di successo potrebbe in seguito richiedere un lavoro di ingegneria per funzionare in modo affidabile all'interno di un prodotto, ed è questo uno dei motivi per cui il confine diventa meno netto nei team maturi.
Anche le metriche di successo differiscono. Un data engineer può essere valutato in base all'affidabilità della pipeline, al tempo di elaborazione, alla freschezza dei dati, ai costi, all'uptime e ai risultati dei test di qualità. Un data scientist può essere valutato in base alle prestazioni del modello, alla qualità degli esperimenti, all'accuratezza delle previsioni, all'impatto sul business, all'adozione e alla chiarezza delle sue raccomandazioni.
Competenze e strumenti utilizzati da ciascun ruolo:
Entrambi i ruoli richiedono programmazione, capacità di problem solving, comunicazione e una comprensione pratica delle strutture dati. Il linguaggio SQL è comune a entrambi poiché gli ingegneri lo usano per gestire e trasformare i dati, mentre gli scienziati lo usano per recuperarli ed esaminarli. Anche Python viene utilizzato in entrambi i campi, sebbene lo scopo possa variare.
I data engineer richiedono tipicamente forti competenze di ingegneria del software e di sistemi. Il loro toolkit può includere database SQL come PostgreSQL, sistemi NoSQL, piattaforme cloud come AWS, Azure o Google Cloud e tecnologie di elaborazione distribuita come Apache Spark. Apache Kafka può supportare lo streaming di eventi, mentre Apache Airflow o strumenti simili possono pianificare e monitorare i flussi di lavoro. Possono anche lavorare con strumenti ETL o ELT, infrastruttura come codice (IaC), container, controllo di versione e sistemi di governance dei dati.
I data scientist richiedono tipicamente basi più solide in statistica, matematica, progettazione sperimentale e machine learning. Gli strumenti comuni includono Python o R, Pandas, NumPy, scikit-learn, TensorFlow, PyTorch e Jupyter. Strumenti di visualizzazione come Matplotlib, Seaborn, Tableau o Power BI li aiutano a spiegare i risultati. Un data scientist può anche utilizzare SQL, cloud notebooks, strumenti di tracciamento dei modelli e librerie specializzate per il natural language processing o la computer vision.
Questi elenchi non rappresentano confini rigidi. Un data engineer può costruire un piccolo modello predittivo per monitorare una pipeline. Un data scientist può scrivere codice di produzione o progettare una trasformazione dei dati. La distinzione si comprende meglio attraverso il problema principale che ciascuna persona è responsabile di risolvere, piuttosto che attraverso un elenco fisso di software.
Come lavorano insieme
Consideriamo un'azienda di vendita al dettaglio che desidera prevedere la domanda per ciascun punto vendita. I data engineer possono raccogliere lo storico delle transazioni, i livelli di inventario, le promozioni, le festività, le informazioni meteorologiche e i dettagli del negozio. Creano una pipeline coerente, risolvono le differenze negli identificatori dei prodotti, rimuovono i record duplicati e rendono i dati preparati disponibili in un warehouse o in un ambiente di modellazione.
Il data scientist esamina quindi i dati e individua le variabili utili. Testa i metodi di previsione, confronta l'accuratezza, analizza gli errori e stima come le previsioni potrebbero migliorare le decisioni sull'inventario. Spiega i compromessi (trade-off) al team di prodotto o operativo.
Se l'organizzazione decide di utilizzare il modello, il lavoro continua. Gli ingegneri possono creare un processo pianificato che fornisce nuovi dati, memorizza le previsioni, monitora i guasti e serve i risultati a un'applicazione o a una dashboard. Il data scientist può monitorare le prestazioni del modello e verificare se l'accuratezza diminuisce man mano che il comportamento dei clienti cambia.
Questo non è un passaggio di consegne a senso unico. I data scientist potrebbero scoprire che un campo cruciale è mancante o che i timestamp non sono affidabili. I data engineer potrebbero dover modificare la pipeline affinché i dati siano disponibili alla frequenza richiesta. Entrambi i ruoli traggono vantaggio da definizioni chiare, documentazione condivisa e un accordo preventivo sul risultato di business.
Dove si colloca la Business Intelligence
La business intelligence (BI) è correlata a entrambi i ruoli ma ha un'enfasi diversa. La BI di solito trasforma i dati correnti e storici in dashboard, report e viste delle performance accessibili. Aiuta a rispondere a domande come: quali sono state le vendite il mese scorso? Quale regione è al di sotto dell'obiettivo? Come stanno cambiando le richieste di supporto?
La data science guarda spesso più avanti. Può chiedere: cosa è probabile che accada dopo? Quali clienti rischiano di andarsene? Quale prezzo o azione produrrà probabilmente un risultato migliore? Questa è una distinzione semplificata, poiché la BI può includere analisi avanzate e la data science può descrivere le prestazioni passate. Tuttavia, la BI è comunemente associata al reporting descrittivo, mentre la data science è più associata al lavoro predittivo e prescrittivo.
La data engineering supporta entrambi. Fornisce i dati affidabili che alimentano dashboard e modelli. In alcune organizzazioni, gli analytics engineer si collocano tra l'ingegneria e la BI, trasformando i dati del warehouse in modelli ben definiti che analisti e utenti aziendali possono comprendere. Le aziende più piccole possono combinare diverse di queste responsabilità in un unico ruolo, mentre le grandi aziende le separano in modo più netto.
Formazione e percorso di carriera
Non esiste un unico titolo di studio obbligatorio per nessuna delle due carriere, ma i percorsi formativi più comuni riflettono il lavoro svolto. I data engineer provengono spesso da informatica, ingegneria del software, sistemi informativi o campi correlati. La loro formazione enfatizza solitamente database, sistemi distribuiti, infrastruttura cloud, programmazione e system design.
I data scientist possono provenire da statistica, matematica applicata, informatica, economia, fisica o corsi di laurea formali in data science. La loro formazione enfatizza spesso la probabilità, la modellazione statistica, il machine learning, la sperimentazione e la comunicazione. Gli studi avanzati possono essere utili per ruoli fortemente incentrati sulla ricerca, ma contano anche i progetti pratici e solide prove tecniche.
Una persona a cui piace progettare sistemi, migliorare l'affidabilità, scrivere codice di livello di produzione e risolvere problemi di performance potrebbe preferire la data engineering. Qualcuno che ama le domande aperte, il ragionamento statistico, la sperimentazione, la scoperta di pattern e la spiegazione dei risultati potrebbe preferire la data science. Nessun percorso è universalmente più difficile. L'ingegneria comporta spesso problemi operativi e di scala impegnativi, mentre la scienza comporta spesso ambiguità e incertezza. La scelta migliore dipende dal tipo di problema che una persona vuole risolvere.
Falsi miti comuni
Primo, la data engineering non è semplicemente l'amministrazione di database. La conoscenza dei database è importante, ma la moderna data engineering può includere architettura cloud, streaming, orchestrazione, testing, osservabilità, sicurezza ed elaborazione su larga scala.
Secondo, la data science non è solo machine learning. Un buon data scientist può trascorrere molto tempo a definire un problema, esplorare dati, progettare un esperimento, verificare i bias o comunicare un risultato. Un modello complesso non è automaticamente migliore di un'analisi chiara.
Terzo, i ruoli non sono in competizione. Una piattaforma di dati affidabile non sostituisce l'analisi e un modello sofisticato non risolve scarse fondamenta di dati. I team di dati più efficaci comprendono i passaggi di consegne e coinvolgono tempestivamente gli specialisti giusti.
Conclusione
Data engineering e data science rispondono a domande diverse all'interno dello stesso ciclo di vita dei dati. I data engineer rendono i dati affidabili, accessibili e pronti all'uso; i data scientist li usano per spiegare i comportamenti, prevedere i risultati e supportare decisioni migliori. I loro strumenti si sovrappongono e i team più piccoli possono combinare i ruoli, ma l'obiettivo principale rimane diverso: uno costruisce le fondamenta e l'altro ne estrae il significato.
Per un'azienda, la lezione pratica è risolvere il problema delle fondamenta prima di pretendere che un'analisi avanzata produca risultati affidabili. Collaborare con esperti in Data Engineering assicura che i tuoi sistemi siano costruiti su solide basi fin dal primo giorno. Per un individuo, la scelta si riduce al tipo di lavoro che sembra più naturale: costruire sistemi resilienti o indagare su questioni incerte. In entrambi i casi, i risultati migliori si ottengono quando ingegneria e scienza lavorano come partner anziché come reparti separati che si passano un lavoro incompleto da una scrivania all'altra.