Por qué esto ha cobrado tanta relevancia de repente
La ingeniería de datos solía ser el componente silencioso y menos vistoso de la infraestructura tecnológica. Ya no es así.
El mercado global de servicios de ingeniería de datos alcanzó los 105.000 millones de dólares en 2026 y mantiene una proyección orientada a los 213.000 millones de dólares para 2031, lo que representa una tasa de crecimiento anual compuesto del 15% que no muestra signos de desaceleración.
Esta expansión no es simple entusiasmo pasajero; es la respuesta directa a un problema muy costoso: las organizaciones están saturadas de datos que, en la práctica, no pueden utilizar.
Toda empresa que persigue la inteligencia artificial, la automatización o la «toma de decisiones basada en datos» termina encontrando la misma barrera: nada de eso funciona sin una canalización de datos limpia y confiable que lo nutra. Esa es la parte sobre la cual nadie publica en LinkedIn, pero es precisamente la que define si su inversión en IA rinde frutos o se disuelve en una partida presupuestaria que nadie desea justificar en la siguiente junta directiva.
Los ingenieros de datos se han convertido en uno de los perfiles más difíciles de contratar. El sector emplea a más de 150.000 profesionales en todo el mundo y generó más de 20.000 nuevos empleos solo durante el último año. La Oficina de Estadísticas Laborales de EE. UU. proyecta un crecimiento del 36% en puestos vinculados a datos entre 2023 y 2033, una cifra que multiplica ampliamente el promedio general de todas las profesiones.
Una demanda de esta magnitud no surge por una tendencia superficial. Surge porque las empresas finalmente han comprendido que la infraestructura interna subyacente es tan determinante como el producto que opera sobre ella.
2. El piloto de IA que nunca salió del entorno de pruebas
Lo que observamos: Una compañía realiza una fuerte inversión en una iniciativa de IA o aprendizaje automático (ML). La solución funciona en la demostración técnica, pero nunca llega a producción, o si lo hace, nadie confía lo suficiente en sus resultados como para actuar en base a ellos.
Por qué sucede: Los modelos de IA son tan buenos como la calidad de los datos que los alimentan. La mayoría de las organizaciones diseña el modelo primero y detecta las deficiencias de los datos después.
Lo que sucede en toda la industria: Este patrón es ahora la regla y no la excepción.
Gartner pronostica que hasta 2026, el 60% de los proyectos de IA serán abandonados específicamente debido a que la infraestructura de datos subyacente no estaba preparada. No porque el modelo algorítmico fuera deficiente, sino porque nadie estructuró la capa de ingeniería de datos necesaria para sostenerlo.
El aprendizaje real: Si está presupuestando una iniciativa de IA, presupueste en primer lugar la ingeniería de datos sobre la que descansará. Construir el modelo se ha convertido en la parte sencilla; la canalización de datos es donde los proyectos prosperan o fracasan.
Existe una arista aún más contundente: la encuesta para Chief Data Officers (CDO) 2025 de Informatica reveló que la calidad y preparación de los datos es actualmente el mayor obstáculo citado por las organizaciones para el éxito de la IA, por delante del presupuesto, la captación de talento y el respaldo de la dirección. Las empresas no se detienen por falta de modelos solventes; se detienen porque nadie construyó la carretera por la que ese modelo debe transitar.
3. El sistema heredado que nadie se atreve a tocar
Lo que observamos: Un proceso operativo crítico continúa ejecutándose en una infraestructura local (on-premise) implementada hace más de una década. Todos reconocen la urgencia de migrarlo, pero nadie desea asumir el riesgo de ser quien cause una interrupción.
Por qué sucede: Las migraciones de datos se perciben como operaciones de alto riesgo debido a que, históricamente, lo han sido. Una tabla omitida o una dependencia no mapeada pueden comprometer registros históricos acumulados durante años.
La solución: Una migración estructurada por fases: auditar, mapear dependencias, migrar en etapas controladas y validar en cada punto de control. Esto convierte un salto de alto riesgo en una secuencia de pasos reducidos y reversibles. Por este motivo, nuestro proceso de soluciones de ingeniería de datos inicia siempre con una auditoría integral y culmina con soporte continuo, evitando traspasos abruptos en una sola entrega masiva.
La paradoja radica en que cuanto más tiempo posterga una empresa esta decisión, más riesgosa se vuelve la migración definitiva. Cada año que un sistema heredado permanece sin cambios, acumula nuevas reglas lógicas de negocio no documentadas, indiscutidas y cada vez más estructurales. Esperar no hace la migración más segura; simplemente prolonga la auditoría necesaria.
4. La canalización que solo una persona comprende
Lo que observamos: Un único ingeniero diseñó la canalización ETL de la empresa hace dos años. A día de hoy, sigue siendo la única persona capacitada para intervenir cuando ocurre una falla. El resto del equipo evita interactuar con el sistema por temor a desconfigurarlo.
Por qué sucede: Se desarrollan canalizaciones apresuradas bajo la presión de plazos ajustados que terminan operando sin documentación técnica formal ni un proceso adecuado de transferencia de conocimiento.
El coste real: Más allá del evidente riesgo de dependencia de una sola persona («bus factor»), las canalizaciones con documentación deficiente ralentizan cualquier integración futura. Los equipos invierten más horas aplicando ingeniería inversa sobre código antiguo que generando valor nuevo.
La solución: Una arquitectura estructurada acompañada de documentación clara no es un valor secundario prescindible; es el factor que transforma un sistema frágil en un activo escalable sobre el cual todo el equipo puede construir.
5. El vacío de gobernanza postergado indefinidamente
Lo que observamos: Una empresa experimenta un crecimiento acelerado, integra datos procedentes de decenas de fuentes nuevas y aplaza la gobernanza de datos para «el próximo trimestre», de manera consecutiva durante dos años.
Por qué sucede: La gobernanza rara vez se percibe como una urgencia operativa hasta que se transforma de golpe en una crisis crítica: una auditoría de cumplimiento normativo, una brecha de seguridad o un organismo regulador formulando preguntas que nadie puede responder.
El aprendizaje real: Los controles de acceso, las validaciones de calidad y el linaje de datos no son trabas burocráticas. Son la diferencia entre una empresa capacitada para responder con certeza sobre sus propios datos y una que descubre sus vulnerabilidades de la forma más perjudicial.
El marco metodológico que aplicamos antes de modificar una sola canalización
Antes de escribir una sola línea de código para un cliente, formulamos cuatro preguntas esenciales. Es lo que denominamos la «Regla de la Auditoría Primero», una práctica que ha asegurado la viabilidad de más proyectos que cualquier software adquirido:
- ¿De dónde provienen realmente los datos? No según el organigrama teórico, sino en la realidad operativa: incluyendo las tres hojas de cálculo dispersas y la API que nadie documentó.
¿Quién interactúa con ellos y en qué momento se produce la falla? Toda canalización tiene un punto vulnerable. Conviene detectarlo antes de que genere un incidente crítico a medianoche.
- ¿Qué decisión de negocio deben sustentar estos datos? Si nadie puede responder a esto, se está implementando infraestructura por el mero hecho de construirla.
- ¿Qué protocolo se activa cuando el sistema falla? No si falla, sino cuando ocurra la contingencia.
Si un cliente no cuenta con respuestas para estas cuatro preguntas dentro de su configuración actual, no constituye un error de su parte; representa con exactitud la brecha técnica que nuestros servicios de ingeniería de analítica de datos están diseñados para resolver.
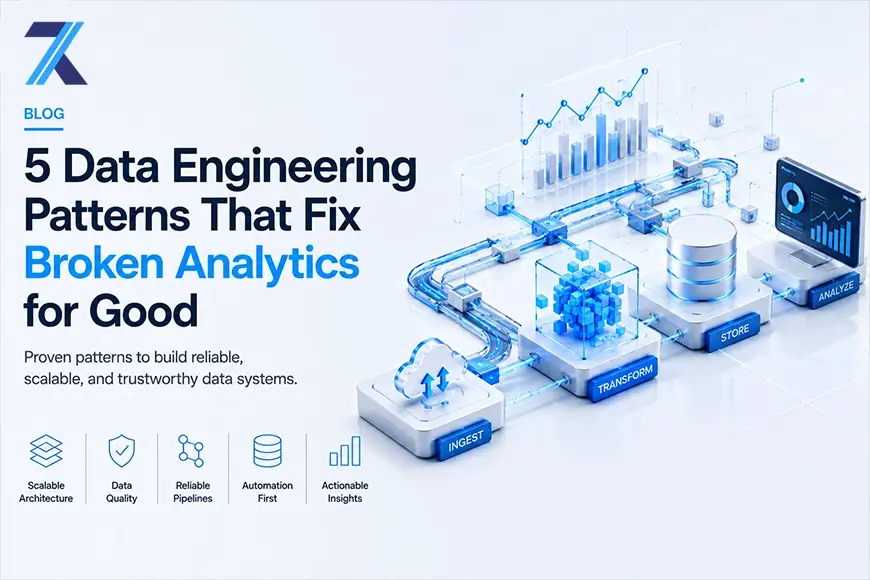
Cinco patrones recurrentes (y el coste que representan)
1. El panel de control en el que nadie confía
Lo que observamos: La empresa dispone de un panel de BI con un diseño visualmente atractivo, pero nadie lo utiliza para tomar decisiones determinantes. En su lugar, tres áreas distintas mantienen sus propias hojas de cálculo «por seguridad».
Por qué sucede: El panel se construyó sobre datos que carecían de validación previa. Un cruce de datos erróneo o registros duplicados bastan para que la confianza se diluya. Una vez perdida, la credibilidad no se recupera simplemente corrigiendo el error técnico.
El coste real: Gartner sitúa el impacto financiero medio de la baja calidad de datos en 12,9 millones de dólares anuales, con estimaciones sectoriales que alcanzan los 15 millones. No se trata de un simple desajuste menor; con frecuencia supera con creces la inversión requerida para desarrollar la ingeniería de datos de forma rigurosa desde el inicio.
La solución: Reconstruir la confiabilidad en el origen, no en la interfaz gráfica. Los controles de gobernanza y las validaciones de datos en fases iniciales (upstream) son mucho más determinantes que un gráfico estilizado en las fases finales (downstream). Hemos visto organizaciones encargar el rediseño completo de un panel, invertir semanas en nuevos gráficos y filtros, para terminar enfrentando la misma incertidumbre, debido a que las tablas subyacentes conservaban los mismos errores no detectados. El panel nunca fue el problema de fondo; fue simplemente el lugar donde la falla se hizo visible.
Qué tienen en común estos patrones
Al examinar estos cinco escenarios, surge una conclusión indiscutible: casi ninguno corresponde a deficiencias tecnológicas. Son problemas de secuenciación metodológica.
Las organizaciones construyen el panel antes de validar los datos. Desarrollan el modelo de IA antes de estructurar la canalización. Migran sistemas sin trazar previamente el mapa de dependencias. En cada instancia, la solución no reside en incorporar herramientas más complejas, sino en ejecutar el trabajo técnico fundamental en el orden correcto.
Esa es la premisa bajo la cual estructuramos las soluciones y servicios de ingeniería de datos en 7 Kings Code. Sin artificios ni precipitaciones: de manera metódica y siguiendo una secuencia diseñada para resistir las exigencias reales del negocio.
- La Auditoría se sitúa en primer lugar, ya que no es posible diseñar arquitecturas para resolver problemas que aún no han sido identificados.
- La Arquitectura precede a la escritura de código en las canalizaciones, evitando adaptar la escala a posteriori sobre sistemas que nacieron para operaciones más reducidas, origen habitual de la mayor parte de la deuda técnica.
- La Implementación comprende las fases de construcción, prueba y despliegue; orientada no solo a una entrega inicial, sino concebida para soportar volúmenes de datos reales, heterogéneos y en constante expansión.
- Y el Soporte no concluye con el despliegue: las canalizaciones precisan monitorización continua y equipos técnicos atentos a responder ante una alerta antes de que se convierta en una caída de servicio.
Qué implicaciones tiene esto para su equipo
Si alguno de estos cinco patrones le resulta familiar, su organización no está rezagada. Se encuentra exactamente donde se hallan la mayoría de las empresas en crecimiento: gestionando un volumen de datos superior a la capacidad para la cual fue diseñada su infraestructura actual.
La ventaja radica en que subsanar esta situación no exige desmantelar los sistemas existentes para comenzar de cero. Requiere una auditoría rigurosa, una arquitectura adaptada a sus metas reales de crecimiento (y no a la escala de hace dos años) y un socio tecnológico que mantenga su acompañamiento tras el lanzamiento.
Asimismo, solemos cuestionar una creencia extendida: la idea de que estructurar estas bases solo compensa al alcanzar un tamaño corporativo considerable. En la práctica, cuanto antes invierte una empresa en servicios sólidos de ingeniería de datos, menor es el coste de implementación y menor la deuda técnica acumulada por resolver más adelante. Postergar la decisión hasta que los paneles sean inoperables o las iniciativas de IA se detengan solo conduce a asumir costes superiores bajo mayor presión operativa.
En torno a estos principios articulamos nuestros servicios de Ingeniería de Datos: almacenamiento analítico (data warehousing), canalizaciones ETL/ELT, migración de datos, marcos de gobernanza y analítica en tiempo real, respaldados por una metodología que parte del análisis de sus datos reales y no de plantillas preconfiguradas.
Analicemos sus datos conjuntamente
No planteamos que los desafíos de una canalización se resuelvan con fórmulas universales: cada entorno requiere un análisis específico. No obstante, nuestra experiencia analizando estos cinco patrones en diversos sectores nos permite identificar con rapidez dónde situar el foco de atención inicial.
Si sus paneles de control transmiten incertidumbre en lugar de sustentar la toma de decisiones, conversemos con su equipo de datos para examinar el estado de su infraestructura subyacente.