為何此事突然變得如此關鍵
資料工程過去曾是整個技術架構中默默無聞、不起眼的底層。如今情況已大不相同。
全球資料工程服務市場規模在 2026 年已達 1,050 億美元,並預計在 2031 年達到 2,130 億美元,以 15% 的複合年均增長率持續攀升,且絲毫沒有放緩的跡象。
這種成長絕非噱頭炒作,而是對一項極其昂貴痛點的直接回應:企業正深陷於無法真正加以運用的數據泥淖中。
每家追求 AI、自動化或「數據驅動決策」的企業,最終都會撞上同一堵高牆:如果沒有乾淨、可靠的資料管線作為燃料供應,這一切都無法運作。這正是 LinkedIn 上鮮少有人公開提及的幕後環節,卻也是決定您的 AI 投資究竟能獲得豐厚回報,還是悄無聲息地淪為下一次董事會上無人願意解釋的報銷項目的關鍵所在。
資料工程師本身已成為最難招募的熱門職缺之一。全球該領域從業人員超過 150,000 名專業人士,僅在過去一年就新增了 20,000 多個新職位。美國勞工統計局預測,2023 年至 2033 年間,數據相關職缺將迎來 36% 的成長,這已是所有職業平均成長率的數倍之多。
這種強勁需求並非因為某個職位流行而憑空產生,而是因為企業終於體認到:底層管線架構的重要性,絕不亞於建立在其上的上層產品。
2. 永遠走不出沙盒的 AI 概念驗證專案
我們的實務觀察: 企業投入重金推動 AI 或機器學習專案。它在概念驗證展示(Demo)時表現完美,卻始終無法正式部署至生產環境;或者即便上線了,也無人敢信任其產出成果並據此採取行動。
背後原因: AI 模型的成效取決於餵入數據的品質。多數企業往往先建構模型,隨後才後知後覺地發現底層資料問題。
業界普遍現況: 這種現象如今已成常態,而非個別例外。
Gartner 預測,截至 2026 年,60% 的 AI 專案將遭到放棄,其根本原因正在於底層資料基礎尚未備妥。這並非因為模型本身有瑕疵,而是因為根本沒有人針對支援該模型的資料層進行專門的工程建置。
真實啟示: 如果您正在編列 AI 專案預算,請務必先為底層的資料工程編列充足預算。在現今階段,構建模型已相對容易,而資料管線才是真正決定專案生死的關鍵戰場。
更令人警醒的現實是:Informatica 2025 年 CDO 調查報告指出,「資料品質與就緒度」已成為各組織公認實現 AI 成功的首要最大障礙,其阻力甚至超越了預算、人才與高層支持。企業停滯不前並非因為找不到好模型,而是因為從未有人為模型行駛所依賴的道路鋪平基礎。
3. 人人不敢觸碰的舊有系統
我們的實務觀察: 核心關鍵流程依然運行於十年前的地端(On-prem)系統上。所有人都心知肚明必須進行遷移,卻沒有人願意承擔可能搞垮系統的風險。
背後原因: 資料遷移之所以令人望而生畏,是因為歷史經驗證明它確實充滿風險。遺漏一張資料表或忽略一項依賴關係,就可能導致歷經多年積累的紀錄毀於一旦。
解決方案: 採取分階段遷移——全面審計、梳理依賴關係、分階段受控遷移,並在每個檢驗點進行嚴格驗證。這將高風險的一躍轉化為一系列可控、可逆的漸進步驟。這正是為何我們的資料工程解決方案流程始於審計、終於持續支援,而非採取一刀切的冒險式交接。
諷刺的是,企業拖延得越久,未來的遷移風險就越高。舊系統每擱置一年,就會有更多未經文檔記錄、未經檢驗卻日趨關鍵的業務邏輯被悄然寫入其中。等待並不會讓遷移變得更安全,只會讓未來的審計工作更加漫長且棘手。
4. 只有一人看得懂的資料管線
我們的實務觀察: 兩年前由單一工程師搭建的公司 ETL 管線,至今仍只有該名工程師能在發生故障時進行修復,其他所有人對此都避之唯恐不及。
背後原因: 在緊迫的交付期限壓力下倉促搭建的臨時管線,從未經過妥善的文檔記錄與規範的交接流程。
真實代價: 除了顯而易見的「巴士係數(Bus Factor)」風險外,缺乏文檔的管線會拖慢未來每一次系統整合。團隊花費在逆向工程舊邏輯上的時間,遠遠超過創造新價值本身。
解決方案: 清晰的架構與詳實的文檔並非錦上添花,而是將脆弱脆弱的系統轉化為整個團隊皆能協同擴展的核心資產。
5. 「以後再說」的資料治理斷層
我們的實務觀察: 企業高速擴張,接入了十幾種全新資料來源,卻連續兩年將資料治理工作一季又一季地推遲至「下一季」。
背後原因: 在合規審計、資料外洩或監管機構提出無人能答的問題等危機爆發之前,資料治理往往讓人感受不到緊迫性。
真實啟示: 存取控制、品質檢驗與資料血緣(Data Lineage)絕非繁文縟節。它們決定了一家企業究竟能從容應對自家資料的嚴苛考驗,還是只能在慘痛教訓中發現自己對資料一無所知。
動手修改任何資料管線前,我們所遵循的評估框架
在為客戶編寫任何一行程式碼之前,我們會先提出四個關鍵問題。我們稱之為「審計優先原則(Audit-First Rule)」,它拯救的專案數量遠多於我們購買過的任何工具:
- 資料究竟從何而來? 不是組織架構圖上的理想版本,而是包含三份試算表以及無人記錄之 API 的真實情況。
誰會接觸它?它何時會發生故障? 每條管線都有其薄弱環節。務必在它於凌晨兩點警報大作之前,搶先找出弱點所在。
- 這些資料旨在支援哪項商業決策? 如果無人能回答這個問題,那您只是為了建置基礎建設而建置。
- 當系統發生故障時會發生什麼? 不是「萬一」發生,而是「何時」發生。
如果客戶無法針對其當前架構解答這四個問題,這絕非客戶的過錯,而正是我們的資料分析工程服務致力於填補的缺口。
我們屢見不鮮的五種常見模式(及其付出的代價)
1. 人人都不信任的儀表板
我們的實務觀察: 企業擁有外觀精美的 BI 儀表板,卻沒有人用它來做出任何實質決策。相反地,三個不同的團隊各自保留了專屬的試算表「以防萬一」。
背後原因: 該儀表板建構於未經任何人驗證的資料之上。一次錯誤的表關聯(Join)、一筆重複的紀錄,都會讓信任瞬間瓦解。而一旦信任破滅,絕不會僅僅因為修復了一個 Bug 就能輕易挽回。
真實代價: Gartner 指出,劣質資料品質每年造成的平均財務損失高達 1,290 萬美元,部分預估甚至高達 1,500 萬美元。這絕非小小的四捨五入誤差,而往往遠高於當初一開始就把資料工程做好的成本。
解決方案: 從源頭而非表象重建信任。上游的資料治理與驗證檢驗,遠比下游更美觀的圖表重要得多。我們曾目睹企業耗費數週委託全面重新設計儀表板、製作全新的圖表與篩選條件,最終卻仍回到原點,因為底層資料表依然存在著相同的隱性錯誤。儀表板從來都不是問題的根源,它只不過是問題最終顯露出來的場所而已。
這些模式的共通之處
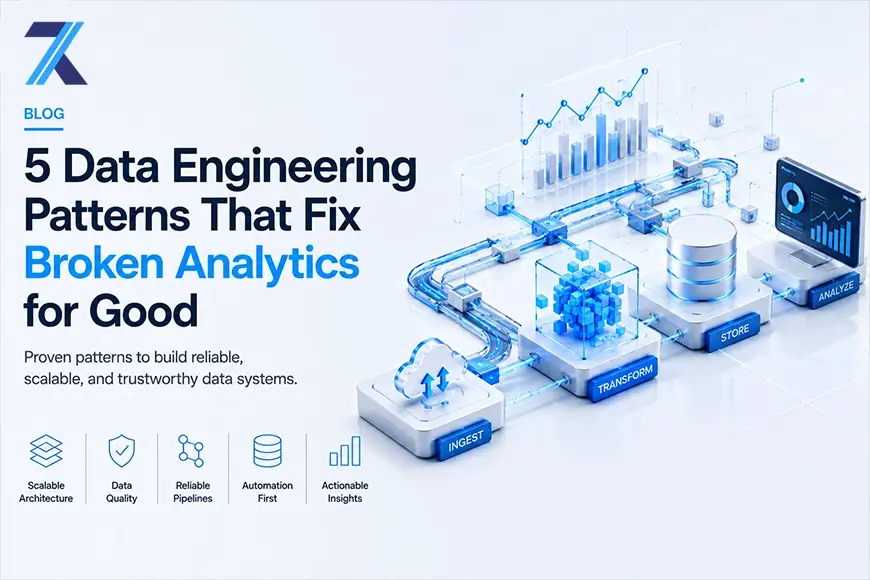
綜觀這五種模式,有一件事顯而易見: 這幾乎全都不是技術問題。 它們是執行先後順序的問題。
企業在驗證資料前就先打造儀表板;在建置資料管線前就先開發 AI 模型;在梳理好依賴關係前就著手遷移系統。在每一個案例中,解方都不是尋求更聰明的工具,而是按照正確順序做好那些不起眼的基礎底層工作。
這正是 7 Kings Code 提供資料工程服務與解決方案時的核心哲學:不浮誇、不冒進,而是條理分明地遵循能在真實商業壓力下經受考驗的嚴謹順序。
- 審計(Audit)優先進行,因為您無法為尚未發掘的問題設計架構。
- 架構規劃(Architecture)在編寫任何一行管線程式碼之前先行確立,因為在為小規模設計的系統上事後硬塞擴展性,正是多數技術債的根源所在。
- 實作導入(Implementation)是我們建構、測試與部署的階段,不僅僅是產出初期版本,而是打造出能夠承受真實、混亂且持續激增之資料量考驗的穩健系統。
- 而 持續支援(Support)不會隨系統上線而終止,因為資料管線不會永遠自行保持正常;它們需要即時監控,並在警報演變成全面當機前有人及時介入處理。
這對您的團隊意味著什麼
如果這五種模式聽起來讓您感到似曾相識,您並未落後。您正處於多數成長型企業當前的共同處境:擁有的資料量遠遠超出了現有基礎架構當初設計所能承載的極限。
好消息是:這一切並不需要將現有系統全盤推翻重來。它需要的是一次開誠布公的審計、一套符合您未來實質發展方向(而非兩年前規模)的系統架構,以及一個在系統上線後仍堅守崗位、而非在管線部署完畢就轉身離去的合作夥伴。
我們也想對一種常見的假設提出委婉反駁:許多人認為只有在企業「規模足夠大」時,才值得解決這些問題。然而在實務上,成長型企業越早投入專業的資料工程服務,修復成本就越低,後續需要清理的技術債也越少。等到儀表板徹底癱瘓或 AI 試點專案陷入停滯才採取行動,只意味著在更大的壓力下付出更加昂貴的代價。
這正是我們的 資料工程服務(Data Engineering services)的核心價值所在——圍繞資料倉儲、ETL/ELT 管線、資料遷移、資料治理與即時分析,以貼合您真實數據而非套用通用範本的專業流程為後盾。
讓我們一起檢視您的資料現況
我們不會宣稱所有管線問題都有萬用通用的解方——事實上絕無可能,任何聲稱有通用解法的人顯然都未曾親手建置過管線。但我們在各個產業中看過太多這五種典型模式,深知應當從何處著手排查問題。
如果您的儀表板給人的感覺更像是一場猜謎遊戲而非決策工具, 讓我們與您的資料團隊深入交流,一同揭示底層究竟發生了什麼。