Perché tutto questo è diventato improvvisamente così importante
Il data engineering era considerato il livello silenzioso e poco appariscente dello stack tecnologico. Non più.
Il mercato globale dei servizi di data engineering ha raggiunto i 105 miliardi di dollari nel 2026 ed è sulla buona strada per toccare i 213 miliardi di dollari entro il 2031, con un tasso di crescita annuale composto del 15% che non mostra segni di rallentamento.
Questa crescita non è una semplice moda passeggera. È una risposta diretta a un problema molto costoso: le aziende stanno annegando in dati che non riescono effettivamente a utilizzare.
Ogni azienda che punta su intelligenza artificiale, automazione o "decisioni basate sui dati" finisce per scontrarsi contro lo stesso muro: nulla di tutto ciò funziona senza una pipeline pulita e affidabile che lo alimenti. Questa è la parte di cui nessuno parla su LinkedIn. Ma è anche la parte determinante per stabilire se il tuo investimento in AI darà i suoi frutti o sparirà silenziosamente tra le voci di spesa che nessuno vorrà giustificare nella successiva riunione del consiglio di amministrazione.
I ruoli di data engineer sono diventati tra i più difficili da assumere. Il settore impiega oltre 150.000 professionisti a livello globale e ha aggiunto più di 20.000 nuovi posti di lavoro solo nell'ultimo anno. Lo U.S. Bureau of Labor Statistics prevede una crescita del 36% nei ruoli legati ai dati tra il 2023 e il 2033: un ritmo svariate volte superiore alla media generale di tutte le occupazioni.
Una domanda di tale portata non dipende dall'essere una professione di tendenza. Nasce dal fatto che le aziende hanno finalmente compreso che le fondamenta infrastrutturali contano tanto quanto il prodotto applicato al di sopra di esse.
2. Il progetto pilota di AI mai uscito dalla sandbox
Ciò che vediamo: Un'azienda investe pesantemente in un'iniziativa di AI o ML. Funziona durante la demo. Non arriva mai in produzione, oppure ci arriva e nessuno si fida abbastanza dei risultati per agire di conseguenza.
Perché succede: I modelli di intelligenza artificiale valgono solo quanto i dati che li alimentano. La maggior parte delle aziende sviluppa prima il modello e scopre il problema dei dati solo in un secondo momento.
Cosa succede nell'intero settore: Questo schema rappresenta ormai la norma, non l'eccezione
Gartner stima che fino al 2026 il 60% dei progetti di AI verrà abbandonato proprio perché l'infrastruttura di dati sottostante non era pronta. Non perché il modello fosse scadente, ma perché nessuno ha ingegnerizzato il livello dei dati per sostenerlo.
Il vero insegnamento: Se stai pianificando un budget per l'AI, stanzia prima le risorse per il data engineering sottostante. Il modello è la parte semplice oggi; la pipeline è il punto esatto in cui i progetti vivono o muoiono realmente.
C'è una versione di questo scenario che pesa ancora di più: il sondaggio CDO 2025 di Informatica ha rilevato che la qualità e la prontezza dei dati rappresentano oggi il singolo ostacolo principale identificato dalle organizzazioni per il successo dell'AI, prima ancora del budget, dei talenti e del supporto della leadership. Le aziende non si bloccano perché non trovano un buon modello: si bloccano perché nessuno ha costruito la strada su cui quel modello deve viaggiare.
3. Il sistema legacy che tutti hanno paura di toccare
Ciò che vediamo: Un processo critico viene ancora eseguito su un sistema on-premise risalente a dieci anni fa. Tutti sanno che deve essere migrato. Nessuno vuole essere colui che lo manda in crash.
Perché succede: Le migrazioni dei dati sono percepite come rischiose perché, storicamente, lo sono state. Una tabella eliminata per errore o una dipendenza trascurata possono distruggere record accumulati in anni di lavoro.
La soluzione: Una migrazione graduale: verificare, mappare le dipendenze, migrare in fasi controllate e convalidare a ogni checkpoint. Questo trasforma un passaggio ad alto rischio in una serie di piccoli passi reversibili. È esattamente il motivo per cui il nostro approccio alle soluzioni di data engineering inizia con un audit e prosegue con il supporto continuo, anziché con un unico rischioso passaggio diretto.
Il paradosso è che più un'azienda aspetta, più rischiosa diventa la migrazione finale. Ogni anno in cui un sistema legacy rimane intoccato, nuova logica di business vi si inserisce silenziosamente: non documentata, mai messa in discussione e sempre più critica per l'intera struttura. Aspettare non rende la migrazione più sicura: rende solo l'audit finale molto più lungo.
4. La pipeline che solo una persona comprende
Ciò che vediamo: Un singolo ingegnere ha sviluppato la pipeline ETL aziendale due anni fa. È ancora l'unico in grado di intervenire quando si blocca. Tutti gli altri hanno paura di avvicinarsi al codice.
Perché succede: Pipeline create in fretta e con soluzioni di ripiego sotto la pressione delle scadenze non vengono mai documentate né trasferite adeguatamente al team.
Il costo reale: Oltre all'evidente rischio legato al "bus factor", le pipeline scarsamente documentate rallentano qualsiasi integrazione futura. I team finiscono per dedicare più tempo a decifrare la vecchia logica che a generare nuovo valore.
La soluzione: Un'architettura pulita e con documentazione chiara non è un optional: è ciò che trasforma un sistema fragile in un asset su cui l'intero team può costruire.
5. La lacuna di governance del "ce ne occuperemo più avanti"
Ciò che vediamo: Un'azienda cresce rapidamente, raccoglie dati da una dozzina di nuove fonti e rimanda la data governance al "prossimo trimestre", ogni singolo trimestre, per due anni consecutivi.
Perché succede: La governance non sembra urgente fino al momento in cui diventa un'emergenza assoluta: un audit di conformità, una violazione dei dati o un'autorità di regolamentazione che pone domande a cui nessuno sa rispondere.
Il vero insegnamento: I controlli degli accessi, le verifiche di qualità e la tracciabilità dei dati (data lineage) non sono burocrazia. Sono la linea di demarcazione tra un'azienda in grado di rispondere a domande complesse sui propri dati e una che scopre nel modo più duro di non poterlo fare.
Il framework che adottiamo prima di intervenire su qualsiasi pipeline
Prima di scrivere una sola riga di codice per un cliente, poniamo quattro domande. La chiamiamo la regola "Audit-First", ed è ciò che ha salvato più progetti rispetto a qualsiasi software mai acquistato:
- Da dove provengono realmente i dati? Non la versione teorica dell'organigramma. Quella reale, comprensiva dei tre fogli di calcolo e dell'API che nessuno ha documentato.
Chi li gestisce e quando si verificano gli errori? Ogni pipeline ha un punto debole. Individualo prima che si manifesti alle due di notte.
- Quale decisione aziendale devono supportare questi dati? Se nessuno è in grado di rispondere, si sta creando infrastruttura fine a se stessa.
- Cosa succede in caso di interruzione? Non "se" dovesse accadere, ma "quando" accadrà.
Se un cliente non può rispondere a queste quattro domande sulla propria configurazione attuale, non si tratta di una sua mancanza: è esattamente il divario che i nostri servizi di data analytics engineering sono nati per colmare.
Cinque schemi ricorrenti (e il loro costo reale)
1. La dashboard di cui nessuno si fida
Ciò che vediamo: Un'azienda dispone di un'ottima dashboard di BI. Nessuno la usa per prendere decisioni operative reali. Al contrario, tre team differenti continuano a gestire il proprio foglio di calcolo "per sicurezza".
Perché succede: La dashboard è stata costruita su dati che nessuno ha verificato. Una join errata o un record duplicato bastano a distruggere la fiducia. E una volta persa, la fiducia non si recupera semplicemente correggendo il bug.
Il costo reale: Gartner stima che l'impatto economico medio della scarsa qualità dei dati sia di 12,9 milioni di dollari all'anno, con alcune stime che toccano i 15 milioni. Non è un dettaglio trascurabile: spesso supera di gran lunga il costo necessario per strutturare correttamente il data engineering fin dal principio.
La soluzione: Ricostruire la fiducia alla fonte, non in superficie. La data governance e i controlli di convalida a monte contano molto più di un grafico più gradevole a valle. Abbiamo visto aziende commissionare il redesign completo di una dashboard, dedicare settimane a nuovi grafici e filtri, per poi ritrovarsi al punto di partenza perché le tabelle sottostanti contenevano ancora gli stessi errori silenziosi. La dashboard non è mai stata la causa del problema: era solo il punto in cui il problema diventava finalmente visibile.
Cosa hanno in comune questi schemi
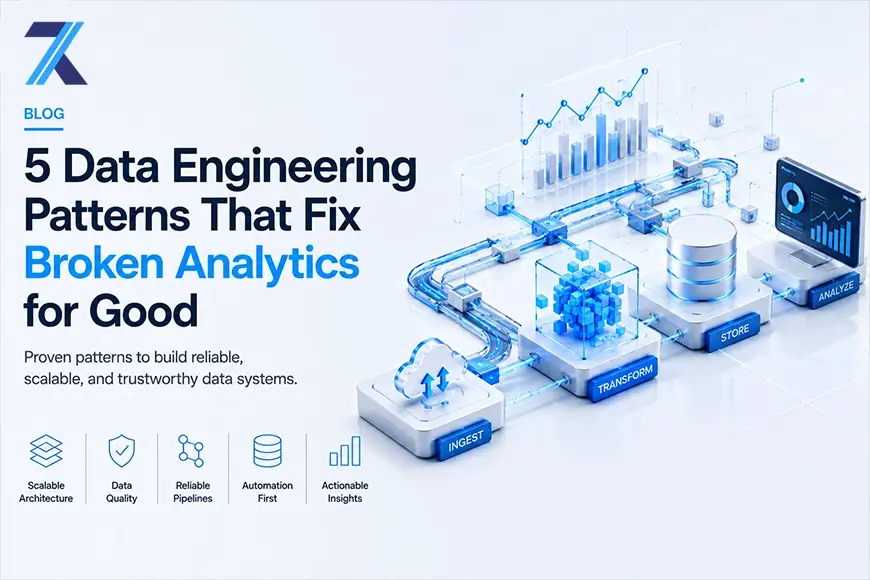
Analizzandoli tutti e cinque, emerge una costante evidente: quasi nessuno di questi è un problema puramente tecnologico. Si tratta di problemi di sequenzialità.
Le aziende realizzano la dashboard prima di validare i dati. Costruiscono il modello di AI prima di ingegnerizzare la pipeline. Migrano i sistemi senza mappare prima le dipendenze. In ogni caso, la soluzione non risiede in uno strumento più avanzato, ma nell'eseguire il lavoro preliminare nell'ordine corretto.
È questa la filosofia alla base del nostro approccio ai servizi e alle soluzioni di data engineering in 7 Kings Code. Senza scorciatoie e senza fretta: con metodo e secondo una sequenza strutturata per reggere sotto la pressione operativa del business.
- Audit viene prima di tutto, perché non è possibile progettare attorno a criticità che non sono ancora state individuate.
- Architettura precede qualsiasi riga di codice della pipeline, poiché tentare di adattare la scalabilità su un sistema progettato per volumi ridotti è il punto di origine della maggior parte del debito tecnico.
- Implementazione è la fase in cui costruiamo, testiamo e rilasciamo: non solo una prima versione, ma una struttura pensata per gestire volumi di dati reali, complessi e in continua crescita.
- E il Supporto non si ferma al rilascio, poiché le pipeline non restano stabili da sole; richiedono monitoraggio continuo e qualcuno pronto a intervenire su un avviso prima che si trasformi in un disservizio.
Cosa significa tutto questo per il tuo team
Se qualcuno di questi cinque scenari ti è sembrato fin troppo familiare, non sei in ritardo. Ti trovi esattamente dove si colloca la maggior parte delle aziende in crescita oggi: con più dati di quanti l'infrastruttura attuale sia in grado di sostenere.
La buona notizia è che nulla di tutto questo richiede di smantellare l'esistente per ripartire da zero. Richiede un audit onesto, un'architettura allineata ai tuoi reali obiettivi futuri (e non a dove ti trovavi due anni fa) e un partner che rimanga al tuo fianco dopo il rilascio, anziché sparire non appena la pipeline entra in produzione.
Ci sentiamo anche di smentire un presupposto comune: l'idea che intervenire su questi aspetti convenga solo una volta raggiunta una determinata dimensione aziendale. Nei fatti, prima un'azienda in espansione investe in veri servizi di data engineering, minori saranno i costi di correzione e il debito tecnico da gestire in seguito. Aspettare che le dashboard siano inutilizzabili o che il progetto pilota di AI sia già bloccato significa soltanto spendere di più, più avanti e sotto una pressione maggiore.
È attorno a questo che sono strutturati i nostri servizi di Data Engineering: data warehousing, pipeline ETL/ELT, migrazione dati, governance e analytics in tempo reale, supportati da un processo che parte dai tuoi dati reali, non da un modello preconfezionato.
Analizziamo insieme i tuoi dati
Non vogliamo affermare che ogni problema infrastrutturale abbia una soluzione standard: non è così, e chiunque sostenga il contrario non ne ha mai costruita una sul campo. Ma abbiamo riscontrato questi cinque schemi in un numero sufficiente di settori da sapere esattamente da dove iniziare a cercare.
Se le tue dashboard somigliano più a una scommessa che a uno strumento per guidare le decisioni operative, parliamo con il tuo team dati e scopriamo cosa sta realmente accadendo sotto la superficie.