なぜ今、これほど重要視されているのか
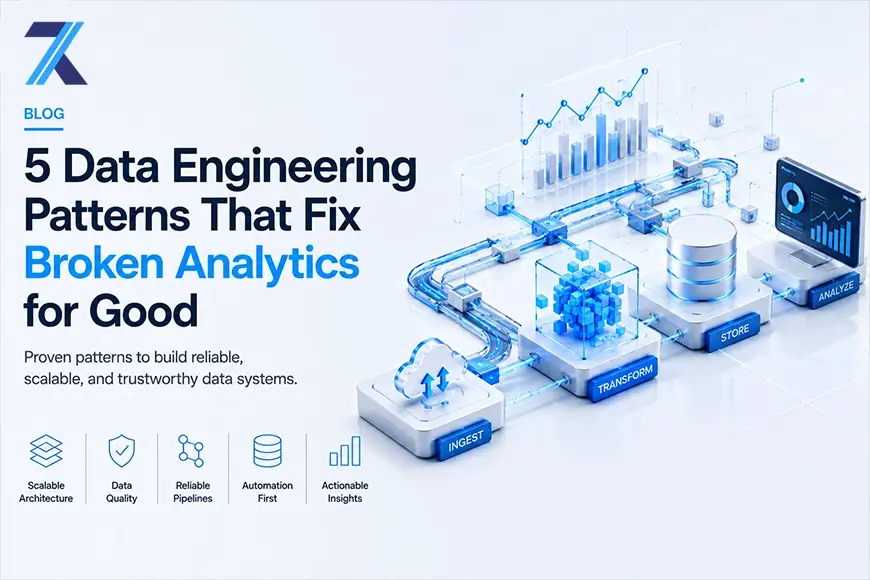
データエンジニアリングは、かつて技術スタックの中でも目立たず地味なレイヤーと見なされていました。しかし、今やそれは過去の話です。
世界のデータエンジニアリングサービス市場は2026年に1,050億ドルに達し、2031年までに2,130億ドル規模へと成長する見通しです。年平均成長率(CAGR)15%というこの急成長の勢いは衰える気配がありません。
この成長は決して一時的なブームや誇大広告ではありません。「企業が活用できない膨大なデータに溺れている」という、極めて莫大なコストを伴う課題に対する直接的な市場の反応です。
AI、自動化、あるいは「データドリブンな意思決定」を追求するすべての企業は、最終的に同じ壁に直面します。クリーンで信頼性の高いパイプラインからのデータ供給がなければ、それらは何ひとつ機能しないということです。これこそが、LinkedInなどでは誰も語りたがらない泥臭い現実です。そして、これこそが貴社のAI投資がリターンを生むか、それとも次回の取締役会で誰も触れたがらない無駄な費目として静かに消え去るかを決定づける分水嶺なのです。
データエンジニア自体も、最も採用が困難な職種のひとつとなっています。世界中で15万人以上の専門職が従事しており、過去1年だけでも新たに2万人以上の雇用が創出されました。米国労働統計局(BLS)は、2023年から2033年にかけてデータ関連の職種が36%増加すると予測しています。これは全職種の平均成長率を何倍も上回る数字です。
このような旺盛な需要は、単にトレンドだから生まれるのではありません。その上に乗るプロダクトと同じくらい、基盤となる配管設備(データエンジニアリング)が重要であると企業がようやく気づき始めたからです。
2. サンドボックスから出ることのなかったAIの実証実験(PoC)
現場で見られる実態: 企業がAIや機械学習のプロジェクトに多額の投資を行い、デモ環境では見事に動作したものの、本番環境にデプロイされないまま終わる。あるいは本番運用に至っても、誰もその出力を信用して意思決定を下すことができない。
原因: AIモデルの精度は、そこに供給されるデータの品質以上に高くなることはありません。多くの企業は最初にモデルを構築し、後になってからデータの欠陥や課題に直面します。
業界全体の実態: このパターンは今や例外ではなく、むしろ常態化しています。
Gartnerの予測によると、2026年までにAIプロジェクトの60%が中止・破棄されると見込まれており、その理由は基盤となるデータレディネス(データの準備状態)が整っていないことにあります。モデル自体の出来が悪かったからではなく、それを支えるデータレイヤーの設計を誰も行っていなかったことが原因です。
真の教訓: AIの予算を組む際は、まずその土台となるデータエンジニアリングの予算を優先して確保すべきです。今日において、モデルの作成自体は比較的容易な工程です。プロジェクトの成否を分ける本当の勝負どころは、データパイプラインにあるのです。
さらに痛烈な事実があります。Informaticaによる2025年のCDO(最高データ責任者)調査によると、組織がAIの成功において挙げる最大の障害は、予算、人材不足、経営層のコミットメントを抑え、「データの品質とレディネスの不足」であることが明らかになりました。企業がつまずいているのは優れたモデルが見つからないからではありません。モデルが走行するための道路(データ基盤)を誰も整備していないからです。
3. 誰も触れることを恐れるレガシーシステム
現場で見られる実態: 10年前のオンプレミス環境で、今なお重要な基幹業務プロセスが稼働している。誰もが移行の必要性を理解しているものの、システム障害の引き金を引く当事者になることを恐れて誰も手を出そうとしない。
原因: データ移行はリスクが高く感じられるためです。そして歴史的にも実際にハイリスクでした。テーブルをひとつドロップしたり依存関係をひとつ見落としたりするだけで、何年もかけて蓄積してきた重要なレコードを失う危険性があります。
解決策: 段階的移行の実施です。現状の監査、依存関係のマッピング、制御されたフェーズごとの移行、そしてすべてのチェックポイントでの厳格なデータ検証を行います。これにより、高リスクな賭けを、小さく可逆的な一連の安全なステップへと変えることができます。これこそが、当社のデータエンジニアリングソリューションが単なる一括(ビッグバン型)移行ではなく、綿密な監査から始まり継続的なサポートで完結するアプローチをとる理由です。
皮肉なことに、移行を先延ばしにすればするほど、将来的な移行リスクは膨れ上がります。レガシーシステムに手を付けずに放置している間にも、ドキュメント化されず検証もされない独自のビジネスロジックが暗黙のうちにシステムへ深く組み込まれ、負荷に耐えかねる状態になっていきます。先送りしても移行が安全になることはありません。最終的に必要となる監査と改修の期間がさらに長くなるだけです。
4. 特定の1人しか理解していない属人化したパイプライン
現場で見られる実態: 2年前にひとりのエンジニアが突貫で構築した社内のETLパイプライン。障害が起きたとき、それを修正できるのは今なおそのエンジニアただひとりであり、他のメンバーは触ることを恐れている。
原因: 厳しい納期プレッシャーの中で構築された即席のパイプラインが、ドキュメントも整備されず適切な引き継ぎも行われないまま放置されたためです。
本当の代償: 明確な「バス因子(特定人物の不在リスク)」にとどまらず、ドキュメントの乏しいパイプラインは将来的なシステム連携のスピードを著しく低下させます。チームは新たなビジネス価値を創出する時間よりも、過去の不可解なロジックのリバースエンジニアリングに多くの時間を浪費することになります。
解決策: 明快なドキュメントを備えたクリーンなアーキテクチャは、単なる「あれば良いもの」ではありません。脆いシステムを、チーム全体が安心して拡張できる確かな資産へと転換するための必須要件です。
5. 「後でやればいい」と先送りされるデータガバナンスの欠如
現場で見られる実態: 事業が急成長し、何十もの新しいソースからデータを収集している一方で、データガバナンスへの取り組みを2年連続で毎四半期「来期にやろう」と先送りし続けている。
原因: コンプライアンス監査、データ侵害、あるいは規制当局から誰も答えられない質問を突きつけられるといった、極めて切迫した事態に直面する瞬間まで、ガバナンスの必要性が緊急課題として認識されにくいためです。
真の教訓: アクセス権限管理、品質チェック、データリネージ(データの系譜追跡)はお役所的な形式基準ではありません。これらは、自社のデータに関する厳しい問いに胸を張って答えられる企業と、自社のデータを把握できていないという手痛い現実に後から直面する企業との決定的な違いを生み出します。
単一のパイプラインに手を付ける前に当社が適用するフレームワーク
クライアントのためにコードを1行書く前に、私たちは必ず4つの問いを投げかけます。私たちはこれを「監査ファーストの原則(Audit-First Rule)」と呼んでおり、これまでに導入したどの高額ツールよりも多くのプロジェクトを危機から救ってきました:
- データは実際にどこから生成・供給されているか? 組織図上のきれいなフローではなく、3つの手動スプレッドシートやドキュメントのないAPIが絡み合う現場の実態を正確に把握します。
誰がそのデータに関与し、いつ障害が発生するのか? すべてのパイプラインには脆弱な弱点が存在します。深夜2時に突然の障害で起こされる前に、その箇所を事前に特定します。
- このデータはどのようなビジネス上の意思決定を支えるためのものか? この問いに誰も答えられないのであれば、それはインフラのためのインフラを構築しているに過ぎません。
- 万が一障害が発生した際、何が起こるのか? 「もし起きたら」ではなく、「起きたとき」の備えを定義します。
もしクライアントが現状の体制についてこれら4つの問いに即答できなくても、それは決して恥じるべきことではありません。そのギャップを確実に埋めることこそが、当社のデータアナリティクスエンジニアリングサービスが存在する理由だからです。
頻繁に見られる5つの典型パターン(とその損失コスト)
1. 誰も信用していないダッシュボード
現場で見られる実態: 見た目は洗練されたBIダッシュボードがあるものの、実際の意思決定には誰も使っていない。その代わりに、3つの異なるチームが「念のため」と称してそれぞれ独自のスプレッドシートを運用している。
原因: 誰も検証していないデータの上にダッシュボードを構築したためです。テーブル結合の不備がひとつあったり重複データが1行混入したりするだけで、データに対する信頼は一瞬で崩壊します。そして一度失われた信頼は、単にバグを修正しただけでは決して戻ってきません。
本当の代償: Gartnerの試算によると、低品質なデータがもたらす経済的損失は年間平均1,290万ドルに達し、推計によっては1,500万ドルに上る場合もあります。これは単なる端数計算のズレではありません。多くの場合、最初から適切にデータエンジニアリングを構築する費用を大幅に上回る損失です。
解決策: 画面の表面(サーフェス)ではなく、データの供給元(ソース)で信頼を再構築することです。下流工程でどれほど美しいグラフを描くかよりも、上流工程でのデータガバナンスとバリデーション検証の方がはるかに重要です。ダッシュボードの大規模なリニューアルに踏み切り、何週間もかけて新しいグラフやフィルターを設計したものの、結局元の状態に逆戻りしてしまった企業を私たちは数多く見てきました。元となるテーブルに同じ潜在的エラーが潜んでいたからです。問題はダッシュボードそのものではなく、ダッシュボードが潜在的な問題の顕在化する場所に過ぎなかったのです。
これらのパターンに共通すること
これら5つのパターンを俯瞰すると、ひとつの明白な事実が浮き彫りになります。それは、これらのほとんどが技術的な問題ではないということです。本質的には「順序(シーケンス)」の問題なのです。
企業はデータを検証する前にダッシュボードを作り、パイプラインを整備する前にAIモデルを構築し、依存関係を整理する前にシステムを移行しようとします。どの場合においても、解決策はより高度なツールを導入することではなく、地道で堅実な土台作りを「正しい順序」で実行することにあります。
これこそが、7 Kings Codeにおけるデータエンジニアリングサービスおよびソリューションの根底にある一貫した哲学です。見せかけの派手さや急ごしらえではなく、実際のビジネス環境の高負荷に耐えうる規律あるアプローチを徹底しています。
- 監査(Audit): まだ特定できていない課題を回避してアーキテクチャを設計することは不可能なため、まず最初に行います。
- アーキテクチャ設計(Architecture): パイプラインのコードを1行書く前に実施します。小規模企業向けに作られたシステムへ後から無理に拡張性を組み込もうとすることこそが、技術的負債の最大の温床となるからです。
- 実装(Implementation): 単なる初期バージョンにとどまらず、乱雑で増大し続ける本番データに直面しても破綻しない堅牢な構築・テスト・デプロイを行います。
- そしてサポート(Support): パイプラインは放置して自然に維持されるものではないため、リリース後も継続します。システム障害に発展する前にアラートを確実に検知・対応する専門体制が不可欠です。
これが貴社のチームにとって意味すること
もしこれら5つのパターンのいずれかに身に覚えがあったとしても、貴社が遅れているわけではありません。現在のインフラの許容量を超えるデータを抱えているという、急成長中の企業が直面する典型的なフェーズに位置しているだけです。
朗報なのは、既存のシステムをすべて破棄してゼロからやり直す必要はないということです。必要なのは、率直な現状監査、過去ではなくこれからの成長目標に見合ったアーキテクチャ設計、そしてパイプラインの稼働後に姿を消すのではなく長期的に伴走してくれるパートナーです。
また、私たちが頻繁に耳にする「会社が十分に大きくなってから投資すればよい」という思い込みに対しては、慎重に再考を促したいと思います。実際には、成長段階の早期に本格的なデータエンジニアリングサービスへ投資するほど、改修費用は安く抑えられ、後から解消すべき技術的負債も少なくなります。ダッシュボードが使い物にならなくなったり、AI実証実験が座礁したりするまで放置することは、後からより大きなプレッシャーの中で高額なコストを支払うことを意味します。
これこそが、当社のデータエンジニアリングサービスの基盤です。汎用的なテンプレートではなく、貴社の実際のデータから出発する体系化されたプロセスに支えられた、データウェアハウス、ETL/ELTパイプライン、データ移行、ガバナンス、そしてリアルタイム分析基盤を提供します。
貴社のデータ基盤を一緒に見直してみませんか
すべてのパイプライン課題に万能な解決策が存在するかのように装うつもりはありません。そのようなものは存在しませんし、そう主張する者は実際にシステムを構築したことがない人たちです。しかし私たちは、様々な業界でこれら5つのパターンを数多く経験してきたからこそ、どこから調査に着手すべきかを熟知しています。
もし貴社のダッシュボードが意思決定の確かなツールではなく当て推量の道具になってしまっているなら、ぜひデータチームと対話し、その配管の底で実際に何が起きているのかを明らかにしていきましょう。